llms.txt: qué es y cómo crearlo (guía 2026 con generador, ejemplos y validadores)
Por Esteve Castells




Índice
- ¿Qué es llms.txt?
- Por qué el archivo llms.txt importa para la visibilidad en IA en 2026
- La especificación de llms.txt (estructura y reglas)
- llms.txt vs llms-full.txt vs robots.txt vs sitemap.xml
- Cómo crear tu llms.txt paso a paso (manual)
- Ejemplos reales de llms.txt
- Los mejores generadores de llms.txt en 2026
- Cómo validar tu llms.txt
- Dónde alojarlo y cómo comprobar que es accesible
- Errores habituales que conviene evitar
- ¿Afecta llms.txt de verdad a la visibilidad en la búsqueda con IA?
- Cómo monitorizar si la IA usa tu contenido
- Resumen
- Preguntas frecuentes
Si alguna vez has mirado tu web pensando en un asistente de IA, seguramente te habrás hecho la misma pregunta que cualquier equipo de SEO y de contenidos en 2026: ¿estos modelos leen de verdad mi sitio y, si lo hacen, qué parte? Las páginas tienen mucho ruido: navegación, anuncios, banners de cookies, artículos relacionados, enlaces de relleno en el pie de página. Los modelos gastan tokens en todo eso antes de llegar a la respuesta.
llms.txt es un archivo Markdown que publicas en la raíz de tu dominio (o en una subruta concreta) para dar a las herramientas de IA compatibles un mapa curado de las páginas que importan. Es la respuesta que se ha propuesto a ese problema. Esta guía repasa la propuesta publicada, ejemplos reales y generadores, cómo comprobar y alojar el archivo, los errores habituales y lo que todo el mundo quiere saber: ¿cambia ya algo en ChatGPT, Perplexity, Gemini o las funciones de IA de la Búsqueda de Google?
¿Qué es llms.txt?
llms.txt es un archivo de texto plano en Markdown que se suele servir en https://tudominio.com/llms.txt. La versión 2 de la propuesta también admite subrutas como /docs/llms.txt, que describen solo las páginas que cuelgan de esa ruta. Está pensado para los grandes modelos de lenguaje y los agentes de IA que intentan entender tu sitio sin analizar todas las páginas HTML. Piensa en él como un resumen al estilo de Wikipedia, escrito en Markdown apto para máquinas y curado a mano para dirigir a la IA hacia tu contenido más importante.
Jeremy Howard, cofundador de Answer.AI, publicó la propuesta el 3 de septiembre de 2024 y la actualizó a la v2 el 10 de agosto de 2026, según la especificación publicada en llmstxt.org. La idea se sitúa entre dos archivos que ya conoces: robots.txt (qué pueden y qué no pueden rastrear los bots) y sitemap.xml (una lista de todas las URLs legible por máquinas). llms.txt no es ninguno de los dos. Es un resumen curado por personas que explica tu sitio, escrito en Markdown para que los LLM puedan analizarlo de forma barata y precisa.
Algunas herramientas generan archivos de contexto más grandes que concatenan el contenido de las páginas, pero llms-full.txt no está definido en la propuesta de llms.txt. Lo que la v2 recomienda es ofrecer una versión Markdown de cada página enlazada (por ejemplo pagina.md o pagina.html.md); los paquetes de contexto más grandes siguen siendo cosa de cada herramienta.
Si quieres ver uno en producción, el nuestro está en https://llmpulse.ai/llms.txt.
Por qué el archivo llms.txt importa para la visibilidad en IA en 2026
llms.txt existe porque los LLM no navegan por la web como Googlebot. Cuando le haces una pregunta a Perplexity, a la búsqueda de ChatGPT o a Gemini, el modelo tiene que ingerir el contenido rápido y dentro de una ventana de contexto finita. El HTML está inflado: CSS, JavaScript, navegación, anuncios, barras laterales y banners de cookies se comen tokens que podrían llevar respuestas de verdad. Markdown suele eliminar el marcado de navegación y de presentación, aunque el ahorro de tokens depende de la página original.
Para la búsqueda con IA y los motores de respuesta, importan tres cosas:
- Claridad. ¿Puede el modelo entender de qué va tu sitio en una lectura corta?
- Selección. ¿Le has dicho al modelo qué páginas son las canónicas y cuáles son ruido?
- Velocidad. ¿Puede el modelo obtener tu contenido clave sin 20 idas y vueltas ni un presupuesto de renderizado?
llms.txt aborda las tres. Escribes el resumen una vez, eliges las URLs que importan y las sirves en Markdown ya procesado. Para sitios de documentación y bases de conocimiento puede ser un experimento de bajo coste, pero no es una señal confirmada de posicionamiento ni de citación.
Conviene recordar que la búsqueda con IA es un juego distinto del SEO clásico. Aparecer dentro de ChatGPT o de Perplexity depende menos de los backlinks y más de que tu contenido sea limpio, citable y fácil de ingerir. Ese es el hueco que llms.txt quiere cerrar. Para la foto estratégica completa, nuestra guía de optimización para buscadores de IA explica cómo encaja llms.txt junto a los datos estructurados, el diseño de contenidos y el seguimiento de citaciones.
La especificación de llms.txt (estructura y reglas)
La especificación oficial es deliberadamente mínima. Todo el archivo es Markdown válido y la propuesta solo exige un H1; el resto de elementos son opcionales y van en un orden fijo.
Esta es la estructura canónica:
# Nombre del proyecto

> Una descripción breve, de una sola frase, de lo que hace este sitio o proyecto.

Uno o dos párrafos opcionales de contexto adicional. Este bloque es Markdown libre y puede incluir cualquier detalle que quieras que el LLM conozca antes de explorar los recursos listados.

## Docs

- [Quickstart](https://example.com/docs/quickstart): Descripción de una línea de la página.
- [API reference](https://example.com/docs/api): Qué cubre esta página.

## Examples

- [Hello world example](https://example.com/examples/hello): Descripción.

## Optional

- [Changelog](https://example.com/changelog): Menos crítico, se puede omitir si el contexto va justo.
Las reglas son:
- H1 (obligatorio). El nombre de tu sitio o proyecto. Es el único elemento obligatorio.
- Resumen en blockquote (opcional). Puede ir justo después del H1. La propuesta no fija un límite de 200 caracteres.
- Prosa libre (opcional). El Markdown que va después del blockquote aporta contexto.
- Secciones H2 (opcional). Agrupan enlaces de Markdown bajo encabezados como Docs, API, Examples o Tutorials.
- Notas en los enlaces (opcional). Un enlace puede ir seguido de dos puntos y una descripción; la descripción no es obligatoria.
- Sección Optional. En la v2, "Optional" es una convención para agrupar enlaces secundarios que un agente puede saltarse cuando necesita un contexto más corto. El encabezado no tiene un significado mecánico especial.
Esa es toda la especificación. Sin XML, sin JSON, sin front-matter, sin paso de validación de schema. La simplicidad es justo lo que se busca: un LLM debería poder analizar el archivo con un parser de Markdown básico y recorrer la estructura de forma semántica.
llms.txt vs llms-full.txt vs robots.txt vs sitemap.xml
Estos cuatro archivos se confunden constantemente. Cada uno sirve para algo distinto:
| Archivo | Público | Formato | Qué contiene | ¿Obligatorio? |
|---|---|---|---|---|
| robots.txt | Rastreadores (Googlebot, GPTBot, etc.) | Directivas en texto plano | Reglas de allow / disallow por user-agent | Opcional pero estándar |
| sitemap.xml | Rastreadores de los motores de búsqueda | XML | Todas las URLs del sitio, con fechas de última modificación | Recomendado para SEO |
| llms.txt | LLM y agentes de IA | Markdown | Índice curado de las páginas clave con descripciones | Propuesta emergente, voluntaria |
| Paquete de contexto generado (por ejemplo, llms-full.txt) | Herramientas o agentes concretos | Específico de cada implementación | Contenido de páginas seleccionado y ensamblado para una ventana de contexto | No forma parte de la propuesta de llms.txt |
Dicho de otro modo: robots.txt fija los permisos de rastreo, sitemap.xml lista las URLs canónicas para los buscadores y llms.txt propone un índice curado en Markdown para las herramientas de IA compatibles. Los paquetes de contexto generados son artefactos opcionales de cada herramienta. Google dice que no hace falta ningún archivo especial para las Vistas creadas con IA (AI Overviews) ni para el Modo IA (AI Mode).
Si todavía no has comprobado qué rastreadores de IA permite tu sitio, empieza por ahí. Nuestra guía (en inglés) sobre si tu web es rastreable por la IA repasa los user-agents y las cabeceras que tienes que revisar.
Cómo crear tu llms.txt paso a paso (manual)
Los generadores sirven para una primera pasada, pero un llms.txt escrito a mano sale sistemáticamente mejor. Los generadores automáticos tienden a meter demasiadas URLs e inflar el archivo, o a saltarse por completo los párrafos de contexto. Este es el flujo de trabajo que funciona en la práctica.
Paso 1: elige tu H1 y el resumen de una línea. El H1 es el nombre de tu empresa o producto. El resumen del blockquote es el elevator pitch. Los dos deberían coincidir con cómo le describirías el sitio a una persona de un tirón. Nada de palabrería de marketing.
Paso 2: escribe el párrafo de contexto. Una o dos frases justo debajo del blockquote. Dile al LLM a qué público te diriges, sobre qué temas tiene autoridad tu sitio y qué debería esperar quien lo lea. Es la parte de la especificación que más se pasa por alto y la que más rinde, porque el modelo la usa para decidir cuánto peso da a todo lo que viene después.
Paso 3: enumera tus páginas más importantes. Abre una hoja de cálculo y lista todas las URLs que querrías que citara una IA si surgiera una pregunta relevante. Para un sitio SaaS: precios, las páginas de producto clave, la documentación principal, los posts más citados, el changelog y las páginas de confianza (seguridad, términos, privacidad). Para la mayoría de sitios, apunta a entre 20 y 80 URLs. Menos de 10 se queda corto; más de 200 empieza a desvirtuar la idea.
Paso 4: agrúpalas en secciones H2. Secciones habituales: Docs, API, Tutorials, Examples, Blog, Company, Optional. Elige las agrupaciones que encajen con cómo navegaría por tu sitio un LLM con curiosidad. Cada sección debería tener entre 3 y 30 enlaces; si una llega a 100, divídela.
Paso 5: escribe una descripción de una línea por enlace. La descripción que va después de los dos puntos es la segunda función más olvidada de la especificación, y tu oportunidad de decirle al modelo qué cubre realmente cada página. Sé concreto. "Precios" es flojo. "Comparativa de planes con el desglose de funciones y los precios mensuales actuales" es fuerte.
Paso 6: mueve el contenido secundario a Optional. Changelogs, páginas legales, posts de baja prioridad: todo lo que no necesitas que se cite con urgencia. El H2 "Optional" es una convención para los enlaces que un agente puede saltarse si va justo de contexto; en la v2 el encabezado no tiene un significado mecánico especial.
Paso 7: crea un paquete de contexto solo si lo necesita una herramienta concreta. Un generador puede ensamblar páginas seleccionadas en Markdown para una ventana de contexto, pero el nombre del archivo y el formato dependen de cada implementación y no forman parte de la propuesta.
Paso 8: valida, aloja y enlaza. Valida el archivo (siguiente sección) y súbelo a la raíz o a la subruta que corresponda. Para que los agentes lo descubran, la v2 recomienda que cada página apunte a su llms.txt con un enlace rel="describedby" en el HTML o con una cabecera HTTP Link.
Ejemplos reales de llms.txt
Mirar archivos en producción es útil, pero las implementaciones cambian y no demuestran que un buscador las consuma. Verifica cualquier ejemplo antes de copiar su estructura. Estos son algunos que hemos comprobado el 10 de noviembre de 2026:
FastHTML. La propuesta enlaza a FastHTML como ejemplo de referencia, con un llms.txt en /docs/ y versiones .md de sus páginas de documentación.
Mintlify. Como plataforma de documentación, Mintlify genera llms.txt automáticamente para los sitios de sus clientes. Su propio archivo enlaza a un índice de la documentación y a las páginas de referencia de la API.
Perplexity. Perplexity publica un índice llms.txt de su documentación para desarrolladores. Demuestra que el formato es útil como infraestructura de documentación, pero no es una prueba de que Perplexity posicione sitios de terceros a través de llms.txt.
Anthropic, Stripe y Cloudflare. Las tres publican un llms.txt para su documentación de desarrolladores. Es el patrón más extendido: el formato prende sobre todo en documentación técnica, donde los agentes de programación leen páginas bajo demanda.
El patrón práctico es la selección, no la exhaustividad. Mantén las descripciones exactas, lista los recursos canónicos y no conviertas el archivo en un segundo sitemap.
Los mejores generadores de llms.txt en 2026
Si no quieres escribir el archivo a mano, un generador puede hacer casi todo el trabajo pesado. La calidad varía. Algunos rastrean tu sitemap y producen un monstruo de 5.000 líneas con todos los posts, todas las páginas de categoría y todos los avisos legales. Eso es peor que no tener llms.txt, porque desmonta la premisa de la selección.
Así se comparan los generadores gratuitos más usados:
| Generador | Enfoque | ¿Selección automática? | Genera llms-full.txt | Mejor para |
|---|---|---|---|---|
| Generador de llms.txt de Firecrawl (API obsoleta) | Rastrea el sitio y lo convierte a Markdown | Parcial (limita el número de URLs) | Sí | Sitios con mucha documentación |
| Generación automática de Mintlify | Integrada en la plataforma de documentación | Sí (usa la navegación de la documentación) | Sí | Sitios que ya están en Mintlify |
| Constructor de llms.txt de WordLift | Usa su grafo de conocimiento interno | Sí (agrupación semántica) | Sí | Sitios corporativos con contenido estructurado |
| Plantilla manual de la propuesta de llmstxt.org | Rellenas a mano la estructura documentada | No (seleccionas tú) | No | Quien lo crea por primera vez, sitios pequeños |
| Herramientas CLI de código abierto (varias) | Scripts locales de conversión a Markdown | Depende del script | A menudo sí | Desarrolladores cómodos con la línea de comandos |
Sobre Firecrawl: su API alojada de llms.txt está marcada como obsoleta y se retirará el 10 de diciembre de 2026; la propia empresa recomienda generar el archivo con sus endpoints de mapeo y de scraping por lotes.
En la práctica, si tu sitio ya funciona sobre una plataforma pensada para documentación, el generador integrado es la opción correcta. Si llevas un blog o una web de marketing, un generador basado en rastreo te dará un primer borrador que luego deberías recortar entre un 30 % y un 70 %. Los generadores que se limitan a volcar el sitemap en Markdown producen una salida inflada de la que ningún LLM saca provecho. La selección siempre gana.
También tenemos un generador de llms.txt gratuito que puedes usar para el primer borrador.
Cómo validar tu llms.txt
llms.txt no tiene un schema formal, así que la "validación" es menos rígida que la de JSON-LD o la de sitemap.xml. Aun así, merece la pena hacer estas comprobaciones:
- El Markdown se analiza sin errores. Pasa el archivo por cualquier parser de CommonMark. Si se rompen los encabezados, los enlaces o las viñetas, arréglalos. Los fallos más habituales son asteriscos sueltos y corchetes sin escapar.
- Exactamente un H1. Varios H1 confunden al parser. La especificación es explícita: un H1, arriba del todo.
- La estructura opcional es intencionada. El blockquote y las secciones H2 de enlaces son convenciones útiles, pero la propuesta solo exige el H1.
- Todos los enlaces funcionan. Cada URL del archivo debe devolver un 200. Pasa un comprobador de enlaces: los enlaces rotos restan confianza al archivo.
- Nada de páginas que solo funcionan con JavaScript. Si una página enlazada solo renderiza el contenido con JS, el LLM se descarga el esqueleto HTML y no obtiene nada. Enlaza a un equivalente renderizado en el servidor o a su versión
.md. - Tamaño razonable. Mantén el índice lo bastante curado como para que sea útil. La propuesta no fija un límite de 100 KB ni de tamaño para los paquetes de contexto.
- Codificación UTF-8. Sirve el archivo como texto plano en UTF-8. Pruébalo con curl -I tudominio.com/llms.txt y confirma la cabecera Content-Type.
Han empezado a aparecer validadores de la comunidad: formularios web sencillos que descargan tu archivo, lo analizan y señalan las secciones que faltan o están mal formadas. Además, Lighthouse, la herramienta de auditoría de Chrome, incluye una comprobación de llms.txt en su categoría experimental Agentic Browsing: si el archivo devuelve un error de servidor, lo marca; si no existe (404), la auditoría queda como no aplicable, porque la documentación de Chrome lo considera opcional por ahora. Para la mayoría de equipos, un parser de CommonMark y un comprobador de enlaces son suficientes.
Dónde alojarlo y cómo comprobar que es accesible
La ubicación convencional es /llms.txt en la raíz del dominio. La propuesta también permite un archivo dentro de una subruta cuando el contenido se aplica a una sección concreta; si hay varios, los agentes deberían usar el más específico.
Pasos para alojarlo:
- Sube llms.txt a la raíz de tu web (el mismo directorio desde el que se sirven tu index.html y tu robots.txt).
- Comprueba que responde en https://tudominio.com/llms.txt, desde una pestaña limpia y en modo incógnito.
- Verifica que la cabecera Content-Type sea text/plain o text/markdown. Si tu servidor devuelve application/octet-stream, corrige la configuración del tipo MIME.
- Ajusta la caché con sentido común. Un max-age de un día en Cache-Control es razonable; los LLM no necesitan el archivo actualizado al segundo.
- Si una herramienta concreta necesita un paquete de contexto generado, publícalo en la ubicación que esa herramienta documente.
- Confirma que robots.txt no bloquea la ruta. Bloquea /admin, no /llms.txt.
Una vez publicado, una prueba rápida con curl confirma que es accesible: curl -i https://tudominio.com/llms.txt. Deberías ver un 200, un tipo de contenido de texto plano y tu Markdown en el cuerpo. Si tienes un CDN delante del origen, purga la caché de esa ruta después de cada actualización.
Errores habituales que conviene evitar
La mayoría de los archivos llms.txt rotos comparten el mismo puñado de problemas. Si los evitas, irás por delante de muchas implementaciones.
- Alojarlo con el alcance equivocado. Usa /llms.txt para todo el sitio o un archivo en una subruta, como /docs/llms.txt, para esa sección. Un archivo en una subruta solo describe las URLs que cuelgan de ella.
- Servirlo como HTML. Si tu CMS envuelve el archivo en la plantilla HTML, los parsers de IA se atragantan. Sírvelo en crudo.
- Volcar el sitemap entero. Cinco mil enlaces en llms.txt no son selección, son ruido.
- Un resumen o unos enlaces poco claros. El blockquote y las descripciones son opcionales, pero si los incluyes deben ser concisos y exactos.
- Usar H1 dentro de las secciones. Solo un H1 en todo el archivo. Las secciones son H2.
- Incluir páginas que solo funcionan con JavaScript. Si la página está vacía sin JS, el LLM no obtiene nada.
- Tratar Optional como una instrucción especial. En la v2 es solo una convención para agrupar los enlaces secundarios que un agente puede saltarse.
- Dejar que se quede desactualizado. Trata llms.txt como un sitemap: revísalo cada trimestre y actualízalo tras cambios importantes en el sitio.
- Bloquearlo en robots.txt. Si tu robots.txt bloquea /, impedirás sin querer que los agentes lean justo el archivo que escribiste para ellos.
¿Afecta llms.txt de verdad a la visibilidad en la búsqueda con IA?
Esto es lo que pocas guías dicen con claridad: la propuesta es reciente, la adopción por parte de los grandes motores de IA es desigual y OpenAI no ha confirmado llms.txt como señal de posicionamiento en la búsqueda de ChatGPT, mientras que Google dice explícitamente que la Búsqueda lo ignora. Lo que sí sabemos:
- El formato lo implementan sobre todo plataformas de documentación y herramientas para desarrolladores.
- No hemos encontrado documentación pública de OpenAI, Anthropic ni Perplexity que diga que sus rastreadores usan llms.txt para decidir qué citar.
- La guía de optimización para IA de Google dice que crear y mantener un llms.txt ni perjudica ni ayuda a la visibilidad ni al posicionamiento en la Búsqueda de Google, incluidas sus funciones de IA, porque la Búsqueda lo ignora.
- Un agente o una herramienta de documentación concretos pueden usar llms.txt cuando así lo dice su propia documentación; no des por hecho que todos los agentes lo descargan.
El argumento para publicarlo igualmente es sencillo. Escribir un llms.txt bien pensado lleva unas horas y el archivo es pequeño y barato de alojar, aunque necesita mantenimiento y no debería exponer URLs privadas ni desactualizadas. Aunque ningún gran motor de IA lo trate como señal de posicionamiento, escribirlo te obliga a seleccionar tus páginas más importantes y a explicar el propósito de tu sitio en lenguaje llano. Las dos cosas son útiles de todos modos.
llms.txt se vende como un atajo, y no lo es. Su valor real está en la conversación que obliga a tener: qué páginas te representan de verdad y cuáles sobran. Publícalo si te cuesta poco mantenerlo, mide tus citaciones antes y después, y no le atribuyas un cambio que no puedes aislar.
 Esteve Castells Cofundador de LLM Pulse
Lo que no deberías hacer es tratar llms.txt como un interruptor mágico. Publicar el archivo no te va a llevar a lo más alto de las respuestas de ChatGPT la semana que viene. La visibilidad en IA viene de un contenido accesible y útil y de menciones con autoridad repartidas por la web. Quien gana en la búsqueda con IA trata todo el stack como un sistema. Para ver qué mueve de verdad tu presencia dentro del asistente más usado, lee nuestra guía sobre cómo posicionarte en ChatGPT.
Cómo monitorizar si la IA usa tu contenido
Puedes publicar el llms.txt perfecto y seguir sin saber si ha cambiado algo. La única forma de saberlo es medir: ¿mencionan los modelos de IA tu marca más a menudo, citan tus URLs más a menudo y apareces en las respuestas a los prompts que tus clientes hacen de verdad?
Ese es el problema que resuelve LLM Pulse. Ejecuta tus prompts estratégicos en ChatGPT, Perplexity, Gemini, el Modo IA y las Vistas creadas con IA de Google, hace un seguimiento de la visibilidad de marca y de la frecuencia de citaciones, tuya y de tus competidores, y muestra el Share of Voice en los cinco modelos.
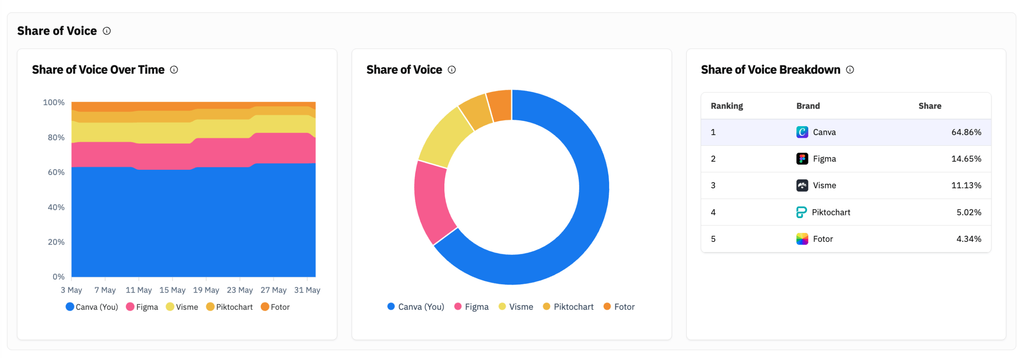
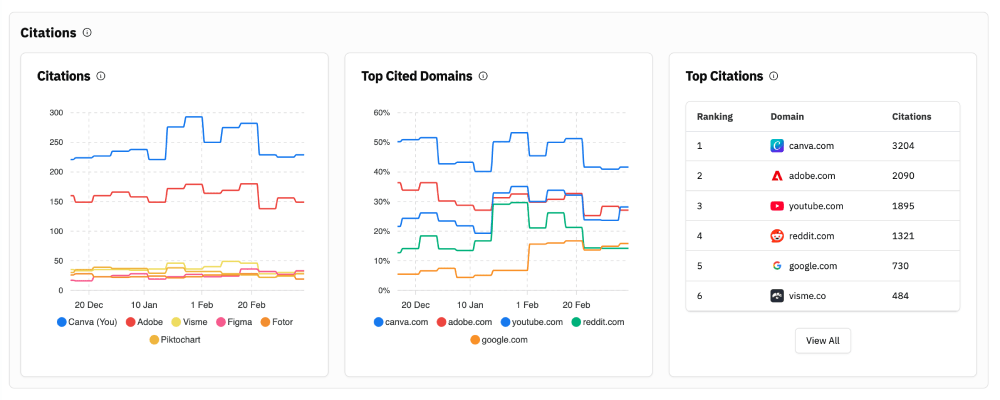
Sigue los recuentos de citaciones y las tasas de mención a lo largo del tiempo, pero no atribuyas un cambio solo a llms.txt: otros cambios de contenido y la propia variación de los modelos también mueven los resultados. Por eso ayuda bajar al detalle de las fuentes: qué dominios y URLs citan los modelos para cada prompt y si las tuyas entran o no.
Y cuando una cifra cambia, abre la respuesta concreta. El detalle de cada respuesta muestra qué dijo el modelo, en qué posición aparece tu marca, con qué sentimiento y qué fuentes citó.
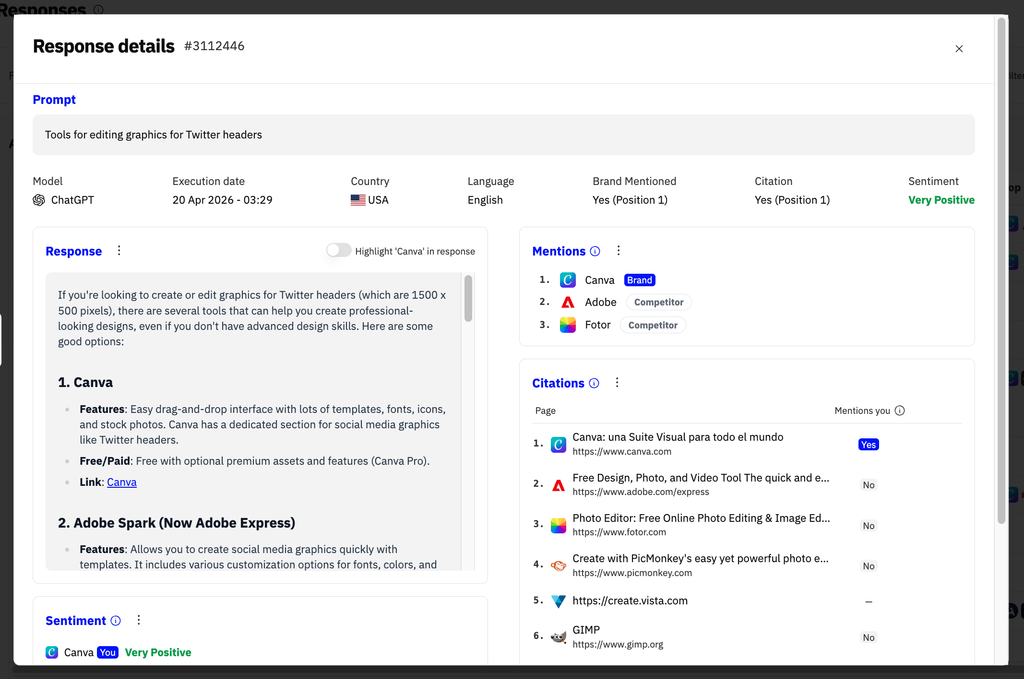
La capa de medición es lo que convierte llms.txt en algo más que una casilla de "ya lo hemos publicado" dentro de un programa de GEO. El principio es el mismo tanto si llevas un equipo interno como si trabajas en una agencia: sin instrumentación, toda optimización (llms.txt incluido) es teórica; con ella, puedes atribuir la mejora, defender el presupuesto y priorizar el trabajo que mueve la visibilidad en IA.
Comprueba si la IA cita tu web
Mide tus menciones, citaciones y Share of Voice en ChatGPT, Perplexity, Gemini y Google antes y después de publicar tu llms.txt.
Resumen
llms.txt es un archivo sencillo y barato que da a los sistemas de IA un mapa curado de tu sitio en Markdown. La especificación, propuesta por Jeremy Howard en 2024 y actualizada a la v2 en agosto de 2026, es deliberadamente mínima: un H1, un resumen en blockquote, secciones H2 con recursos enlazados y una sección Optional, por convención, para lo menos crítico. FastHTML es el ejemplo de referencia, y plataformas como Mintlify, Perplexity, Anthropic o Stripe publican el suyo para su documentación. Un generador produce un primer borrador en minutos, pero las mejores implementaciones siguen siendo las curadas a mano.
Google dice que llms.txt no afecta al posicionamiento en su Búsqueda, y los demás proveedores no han demostrado un beneficio general. El formato aparece en cada vez más sitios de documentación, pero sigue necesitando mantenimiento. Publícalo si el mantenimiento encaja en tu flujo de trabajo y combínalo con trabajo de rastreabilidad y de contenido ya probado.
Lo que no deberías saltarte es la medición. Si no ves si la IA cita tu contenido, no puedes saber si llms.txt funciona. LLM Pulse hace un seguimiento de la visibilidad de marca y de las citaciones en ChatGPT, Perplexity, Gemini, el Modo IA y las Vistas creadas con IA, te da su evolución en el tiempo y el Share of Voice frente a tus competidores, y empieza en 49 € al mes. Para una visión más amplia de las opciones, mira nuestra selección de las mejores herramientas de visibilidad en IA.
Preguntas frecuentes
Es un archivo de texto plano en Markdown, normalmente en https://tudominio.com/llms.txt, que resume tu sitio y enlaza a sus páginas más importantes con una breve descripción. Está pensado para que los LLM y los agentes de IA entiendan tu web sin analizar todo el HTML. Lo propuso Jeremy Howard en 2024 y la especificación vive en llmstxt.org.
En sentido estricto, no. Ningún gran motor de IA ha confirmado que sea necesario para el posicionamiento ni para el rastreo, y Google dice que su Búsqueda lo ignora. Dicho esto, publicarlo es barato (unas horas de trabajo de selección), el archivo es diminuto y algunas herramientas y agentes de documentación ya lo usan. Para sitios con mucha documentación y productos SaaS suele valer la pena.
Normalmente en /llms.txt del dominio correspondiente. La propuesta también permite un archivo para una subruta, como /docs/llms.txt, que describe las páginas de esa sección. Sírvelo como texto Markdown legible en UTF-8. Cualquier paquete de contexto más grande depende de cada herramienta; no hay un complemento estándar llms-full.txt.
No. robots.txt fija los permisos de rastreo (qué user-agents pueden acceder a qué rutas). llms.txt es un índice de contenido curado para que lo consuma la IA. Sirven para cosas distintas y puedes publicar los dos. Asegúrate de que tu robots.txt no bloquea /llms.txt sin querer.
Google puede descubrir y rastrear llms.txt como cualquier otro archivo de texto, pero dice que su Búsqueda lo ignora para la visibilidad y el posicionamiento, incluidas las Vistas creadas con IA y el Modo IA. Google-Extended es un token de control de productos, no un rastreador HTTP independiente.
No directamente, según la información pública de OpenAI en 2026. La búsqueda web de ChatGPT y su forma de citar se apoyan en un abanico de señales más amplio. llms.txt puede ayudar en casos concretos: cuando una herramienta agéntica descarga tu documentación bajo demanda, cuando un buscador de IA que ha adoptado el formato consulta tu sitio o cuando un desarrollador apunta un LLM directamente a tu URL. Para medir cambios reales dentro de ChatGPT, usa una herramienta de seguimiento de visibilidad en IA.
No. La propuesta de llms.txt no define un complemento oficial llms-full.txt. Algunos generadores crean paquetes de contexto con ese nombre o con nombres parecidos, pero su formato y sus reglas de descubrimiento dependen de cada herramienta. Publica uno solo cuando lo documente una herramienta que uses.
No. llms.txt no es un archivo de permisos, es un índice. Si quieres controlar usos concretos, sigue los roles de rastreador que documenta cada proveedor: GPTBot controla el entrenamiento de OpenAI, OAI-SearchBot la búsqueda de ChatGPT, Google-Extended algunos usos de Google ajenos a la Búsqueda, Googlebot las funciones de IA de la Búsqueda de Google y PerplexityBot la búsqueda de Perplexity. Perplexity documenta que su descargador Perplexity-User, activado por el usuario, generalmente ignora robots.txt. Publicar un llms.txt no concede ni deniega nada por sí solo.






Descubre y mejora la visibilidad de tu marca en las búsquedas con IA
Esteve Castells
Cofundador de LLM Pulse y experto en AI Search. Cuenta con una amplia experiencia trabajando como especialista en SEO para marcas globales y grandes empresas, y es el experto responsable de desarrollar el producto para ofrecer el máximo valor a nuestros usuarios.
- llms.txt: qué es y cómo crearlo (guía 2026 con generador, ejemplos y validadores)
- Qué hacen los medios de EE. UU. con los bots de IA: analizamos el robots.txt de 86 cabeceras
- Qué hacen los medios españoles con los bots de IA: analizamos el robots.txt de 88 cabeceras
- Las 15 mejores herramientas de seguimiento de AI Overviews de Google en 2026
- Qué es el AEO (optimización para motores de respuesta): guía 2026